Nouveau challenge Zindi, nouvelle obsession pendant quelques semaines. Celui-ci portait sur un sujet qui me parle particulièrement : prédire des rendements agricoles en Afrique à partir de données satellite, pour le Tchad.
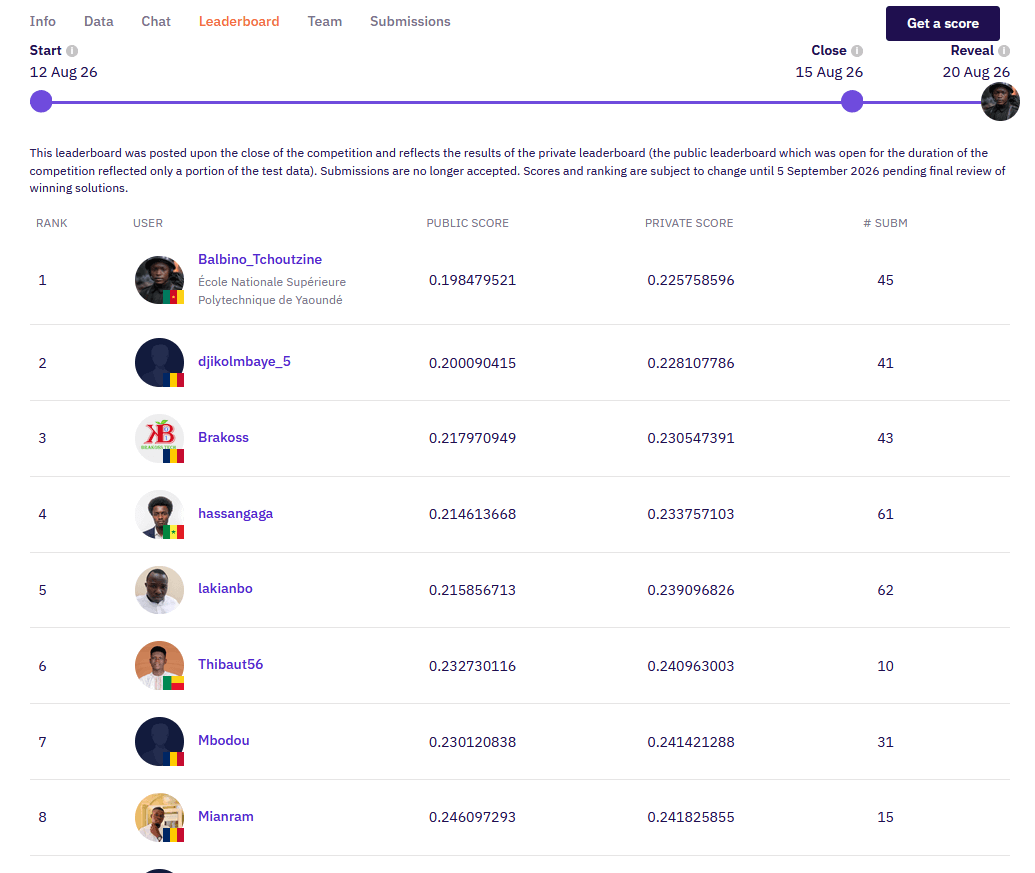
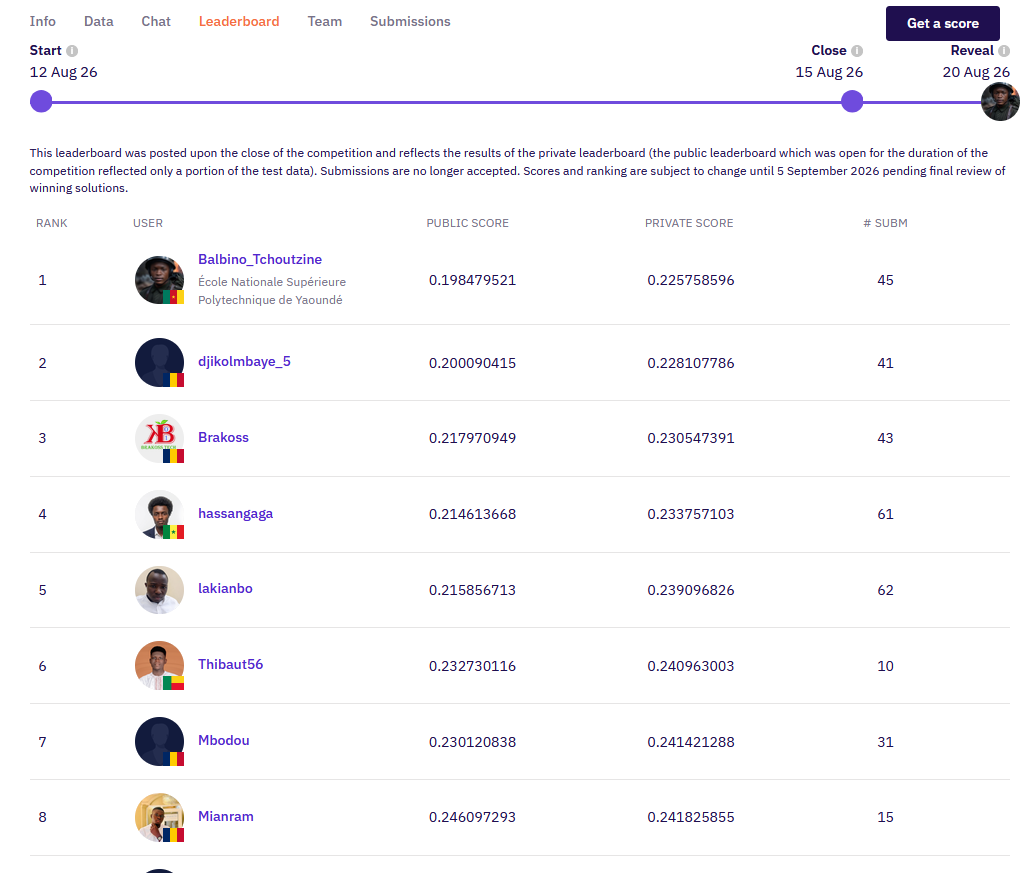
Sous le pseudo Zoom387, j'ai soumis ma solution le 15 août 2026. Score public : wMAPE de 0.19848, 3ᵉ place sur le leaderboard public. Sur le leaderboard privé, celui qui compte vraiment : 1ʳᵉ place.
Le défi : prédire des rendements qui n'existent pas encore
L'énoncé était simple à dire, difficile à faire : prédire le rendement (Rendement_kg_ha) par province, culture et campagne agricole, à partir d'indicateurs climatiques et de végétation dérivés de satellite, plus l'historique des rendements.
Trois obstacles rendaient l'exercice corsé :
- Peu de données : environ 1 800 lignes d'entraînement seulement.
- Le futur à prédire : les années de test (campagnes 2024/2025 et 2025/2026) n'ont ni superficie cultivée ni production connues, seulement les indicateurs climatiques.
- Des départs à froid : la culture Fonio et la province Ennedi Est n'apparaissent que dans le test, jamais dans l'entraînement. Impossible de leur appliquer un historique qui n'existe pas.
La métrique officielle, le wMAPE, pondère les erreurs par la superficie cultivée :
wMAPE = Σ(superficie_i × |rendement_i − prédiction_i|)
        ────────────────────────────────────────────
              Σ(superficie_i × rendement_i)
Se tromper sur une grande exploitation coûte plus cher que se tromper sur une petite parcelle. C'est pour ça que la cible d'entraînement (voir plus bas) est pondérée par la superficie : le modèle apprend directement à minimiser la bonne erreur, pas un proxy.
Construire des features sans aucune donnée externe
Le règlement du challenge imposait de travailler uniquement à partir des fichiers fournis par Zindi (train.csv, test.csv) : aucune donnée FAO, NASA POWER, FAOSTAT ou autre source externe n'était autorisée. Concrètement, ça veut dire que tout signal climatique ou de végétation devait déjà exister dans les colonnes fournies, et que tout le reste (les tendances, les cold starts, les agrégats) devait être reconstruit à partir du seul historique de rendement disponible dans train.csv. Pas de recours à des séries climatiques externes plus longues ou plus fiables pour combler les trous.
Les familles de features construites, et ce que chacune apporte au modèle :
- Historique de rendement (province × culture) : lags 1 à 3, moyenne/écart-type/médiane glissants, tendance linéaire. C'est le signal le plus fort du problème : le rendement d'une culture dans une province est fortement autocorrélé d'une campagne à l'autre. Les lags donnent le niveau récent, l'écart-type glissant capture la volatilité (une culture erratique doit être prédite avec plus de prudence), et la tendance linéaire capte les dynamiques lentes (amélioration des pratiques, dégradation des sols) que les lags seuls ne voient pas.
- Agrégats : statistiques par culture, par province, par zone × culture, par province × culture. Ils servent de filet de sécurité statistique : quand l'historique spécifique à une combinaison province × culture est court ou bruité, le modèle peut s'appuyer sur des moyennes à un niveau plus large pour éviter de sur-apprendre sur trois ou quatre points.
- Climat : indices de végétation (wVHI), température, précipitations, humidité de l'année en cours, plus les anomalies par rapport à la moyenne historique de la province. C'est le seul signal disponible pour les années de test, qui n'ont ni superficie ni production connues. Les anomalies (écart à la normale locale) comptent plus que les valeurs brutes : une saison sèche a un impact différent selon qu'une province est habituellement aride ou humide.
- Départs à froid : le Fonio hérite du comportement des céréales proches (mil, sorgho) par province et année ; l'Ennedi Est hérite des provinces sahéliennes voisines (Kanem, Barh El Ghazal, Wadi Fira, Batha). Sans ça, le modèle n'aurait strictement aucun historique à exploiter pour ces deux cas et devrait extrapoler à l'aveugle.
- Encodages : target encoding lissé et label encoding pour Province, Culture, Zone et Catégorie. Le target encoding lissé permet aux modèles d'arbres de capter directement le niveau moyen de rendement associé à chaque catégorie, sans exploser le nombre de splits nécessaires avec un one-hot classique sur des variables à forte cardinalité.
La cible d'entraînement était log1p(rendement), avec un poids d'échantillon en log1p(superficie) pour aligner l'entraînement directement sur la logique du wMAPE.
Le pipeline : cinq modèles, un stacker, une inférence séquentielle
Pourquoi cinq modèles d'arbres plutôt qu'un seul bien réglé ? Avec seulement 1 800 lignes d'entraînement, un modèle unique, même optimisé, reste sensible au bruit de son propre biais d'apprentissage. L'idée vient de la littérature sur le stacking en compétition (bien documentée sur Kaggle) : des modèles qui font des erreurs différentes, même s'ils sont individuellement proches en score, se corrigent mutuellement une fois combinés. J'ai choisi ces cinq précisément parce qu'ils ne partagent pas tous le même biais :
- LightGBM et XGBoost font tous les deux du gradient boosting, mais avec des stratégies de croissance d'arbres différentes (leaf-wise pour LightGBM, historiquement level-wise pour XGBoost), donc pas exactement les mêmes erreurs.
- CatBoost gère nativement les variables catégorielles avec du boosting ordonné, ce qui limite le sur-apprentissage sur Province, Culture et Zone par rapport à un simple target encoding en amont.
- HistGradientBoosting (scikit-learn) utilise des histogrammes de features, une approche plus proche de LightGBM mais avec sa propre régularisation.
- ExtraTrees casse la logique boosting : c'est un ensemble d'arbres complètement randomisés, sans boosting séquentiel, qui apporte de la diversité brute plutôt qu'une optimisation fine.
Ces cinq modèles entraînés en parallèle sont ensuite empilés par un stacker Ridge sur leurs prédictions out-of-fold, puis une calibration par culture corrige les biais systématiques sans extrapoler.
Le détail qui change tout : les années de test ne sont pas indépendantes. Pour prédire 2025, le modèle a besoin d'un historique 2024, qui n'existe pas encore au moment de l'entraînement. La solution : prédire 2024 d'abord, injecter ces prédictions comme pseudo-labels, reconstruire les features avec cet historique étendu, puis prédire 2025. Une inférence séquentielle, pas un simple batch.
Dernière étape : au lieu de garder une seule seed aléatoire, la solution finale prend la médiane ligne par ligne des prédictions de trois seeds différentes (7, 456, 789). Plus robuste qu'une moyenne face à une seed qui dérape, et ça a battu toutes les alternatives testées (moyenne, moyenne géométrique, blends plus complexes) sur le leaderboard public.
Quelques défis en cours de route
Le pipeline retenu n'est pas sorti du premier coup. Plusieurs pistes qui semblaient raisonnables ont concrètement dégradé le score public :
- Une version "time-safe" de la feature engineering (plus rigoureuse sur le papier) : wMAPE ≈ 0.287.
- Un découpage par catégorie de culture plutôt qu'un modèle global : wMAPE ≈ 0.299.
- Un shrinkage plus agressif sur les prédictions : wMAPE ≈ 0.203.
Les garder dans la documentation de la solution, même après avoir trouvé mieux, c'était important pour moi : ça montre le chemin réellement parcouru, pas juste la ligne d'arrivée.
Résultat
| Split | Score (wMAPE) | Rang |
|---|---|---|
| Public | 0.198479521 | 3ᵉ |
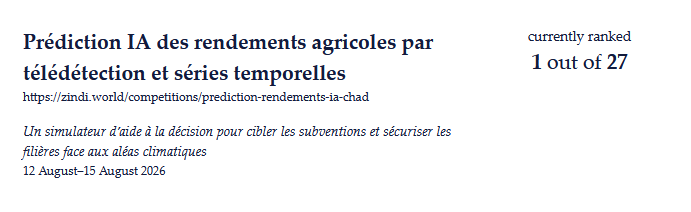
| Privé | 0.225758596 | 1ʳᵉ sur 27 |
Soumission v16_3 (ID e3vJYTzM), le 15 août 2026. Zindi précise que ce classement reste sujet à changement jusqu'au 5 septembre 2026, le temps de la revue finale des solutions gagnantes, ce qui est la procédure normale pour les premières places.
Reproductibilité
Toute la solution est sur GitHub : notebooks, code source, données Zindi, documentation complète (README.md, SOLUTION.md, CODE_REVIEW.md).
github.com/zoom-BT/zindi-chad-crop-yield
python generate_submission.py régénère le fichier soumis à l'identique en moins de 5 secondes à partir des prédictions archivées. Le notebook 02_train_from_scratch.ipynb relance l'entraînement complet des cinq modèles si tu veux vérifier la méthode de bout en bout.
Fun fact
Ce challenge coche exactement les cases qui m'intéressent en ce moment : du ML géospatial appliqué à un problème réel (sécurité alimentaire), des séries temporelles avec des contraintes dures (prédire un futur sans données futures), et un jeu de données pauvre où l'ingénierie de features compte plus que la puissance de calcul.
C'est aussi mon terrain d'entraînement continu comme Ambassadeur Zindi : plus de 19 challenges à ce jour, et celui-ci est sans doute le plus abouti techniquement. La documentation complète de la solution (architecture, ETL, choix de modélisation, gestion d'erreurs) est écrite selon le format que Zindi demande à ses lauréats, exactement comme si elle allait être auditée par un jury.
Ce challenge fait aussi progresser mon classement général sur Zindi :
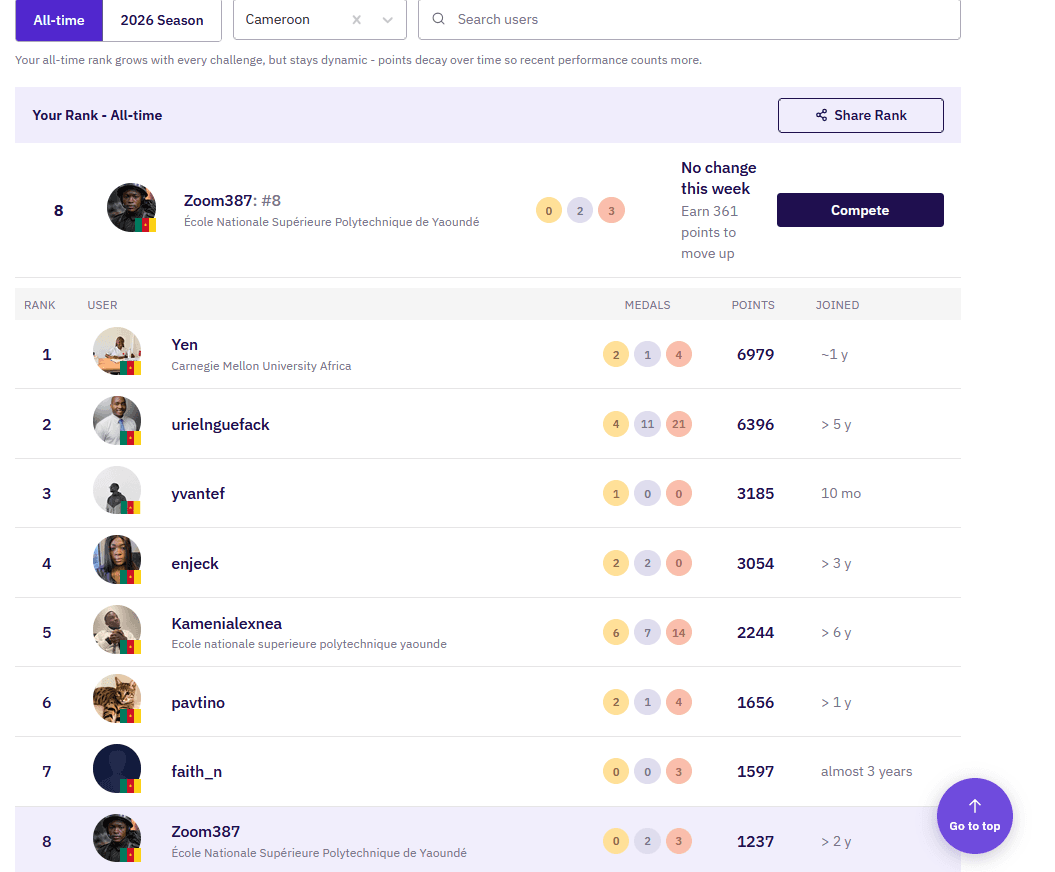
Classement all-time, Cameroun : 8ᵉ sur 285
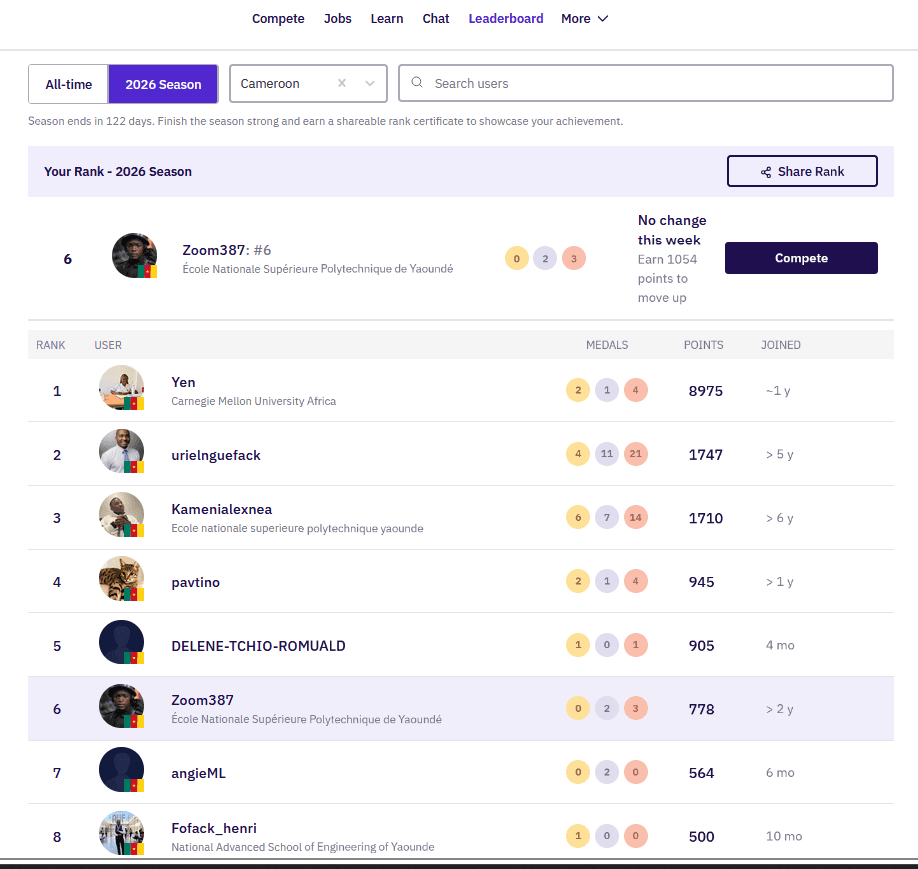
Classement saison 2026, Cameroun : 6ᵉ sur 133
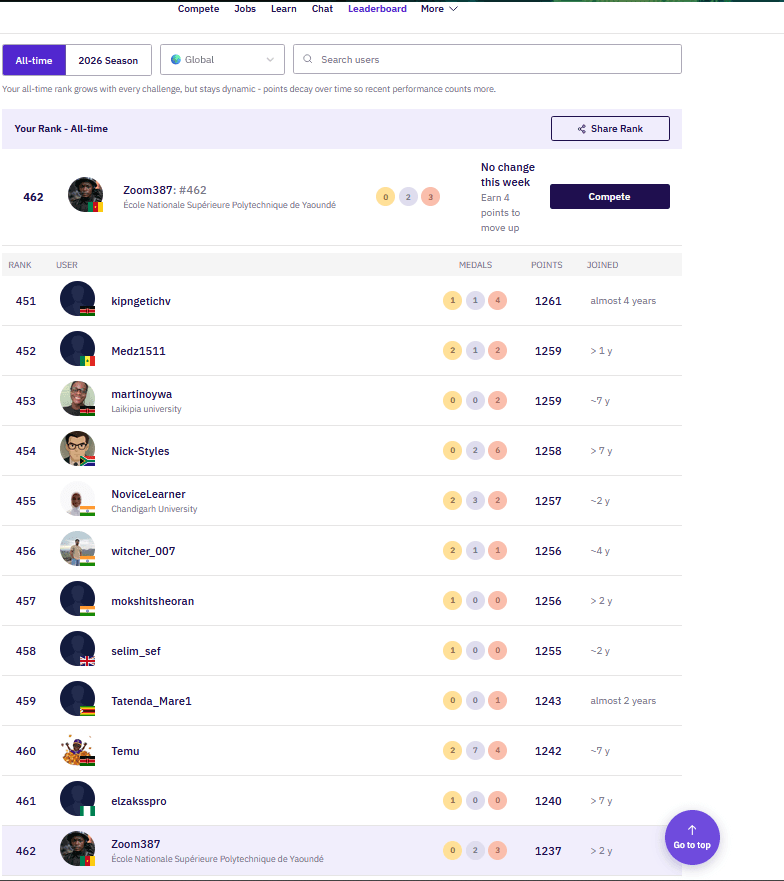
Classement all-time, mondial : 462ᵉ sur 17 834
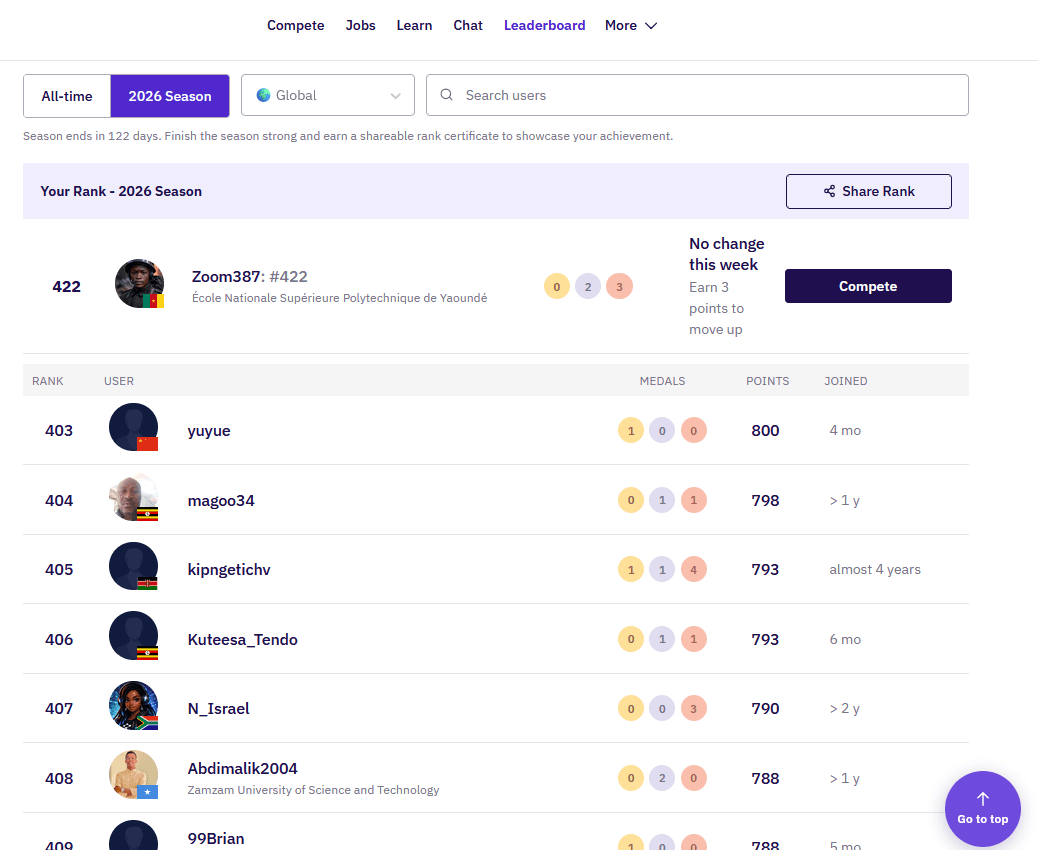
Classement saison 2026, mondial : 422ᵉ sur 5 085